 UltraGX
Ler o resultado
Cada execução deixa duas coisas: um visualizador web para ler e navegar, e uma pasta de arquivos Markdown e JSON para processar, versionar ou entregar a um agente de IA. Os dois têm o mesmo conteúdo.
O visualizador
O visualizador abre na aba Visualizador do aplicativo ou com Abrir no navegador. É um site estático que fica em viewer/ dentro do projeto: funciona sem conexão e pode ser copiado para outra máquina junto com a pasta.
A barra superior tem as seções principais e a busca (Buscar objetos, atalho de teclado /), que encontra objetos pelo nome a partir de qualquer página.
Visão geral
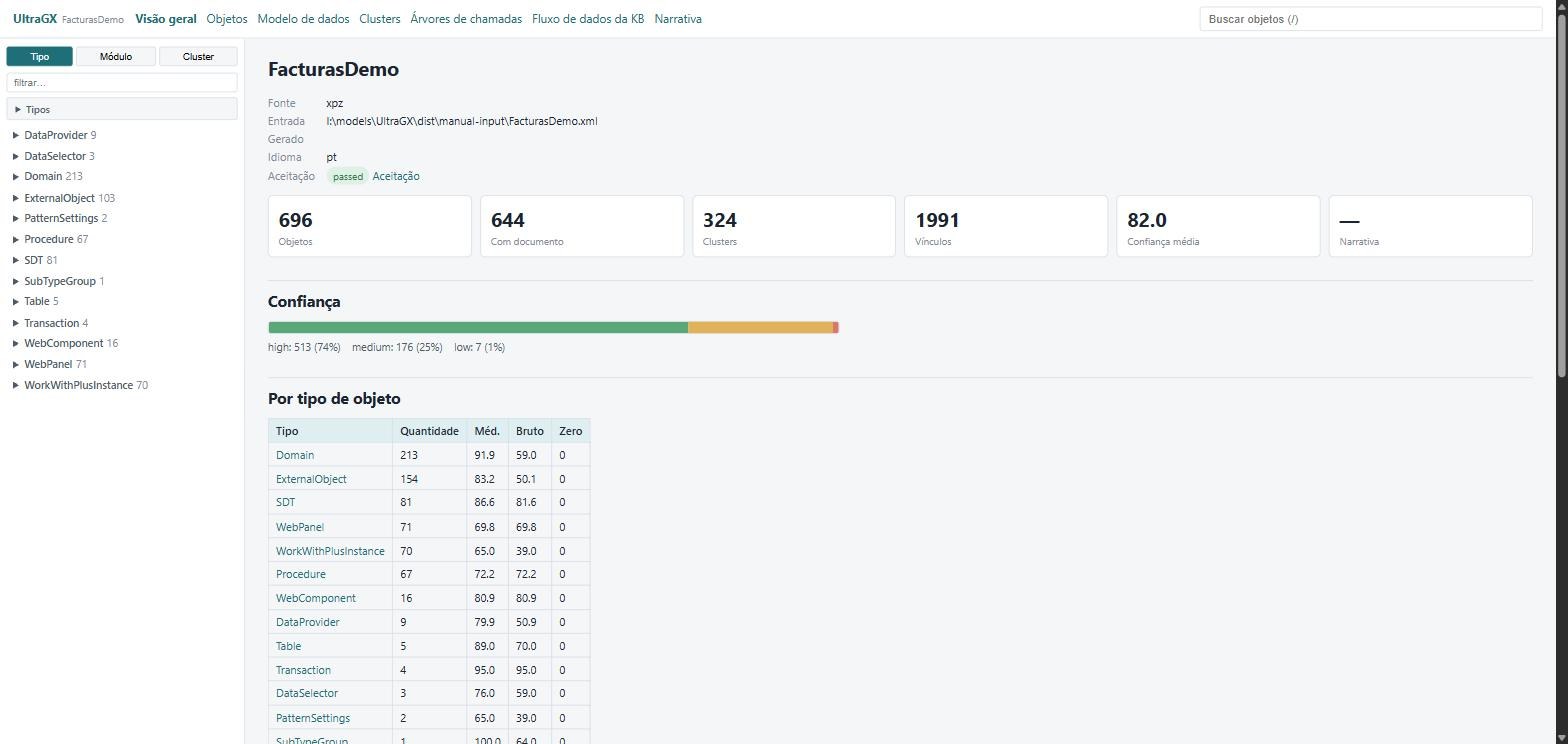
A página inicial mostra de onde veio a KB (fonte, entrada, data, idioma), o resultado do controle de qualidade e os números gerais: objetos, objetos com documento, clusters, relações, confiança média e status da narrativa. Abaixo estão a distribuição da confiança, a tabela por tipo de objeto, os maiores clusters e os links para os relatórios da KB (resumo, roteiro de reconstrução, validação, aceitação).
Confiança (0 a 100) mede quanta evidência o motor encontrou para descrever cada objeto: high, medium ou low. Uma confiança baixa não significa que o objeto esteja errado, e sim que ele tem pouca estrutura para analisar (por exemplo, um procedimento vazio ou um objeto de configuração).
Objetos
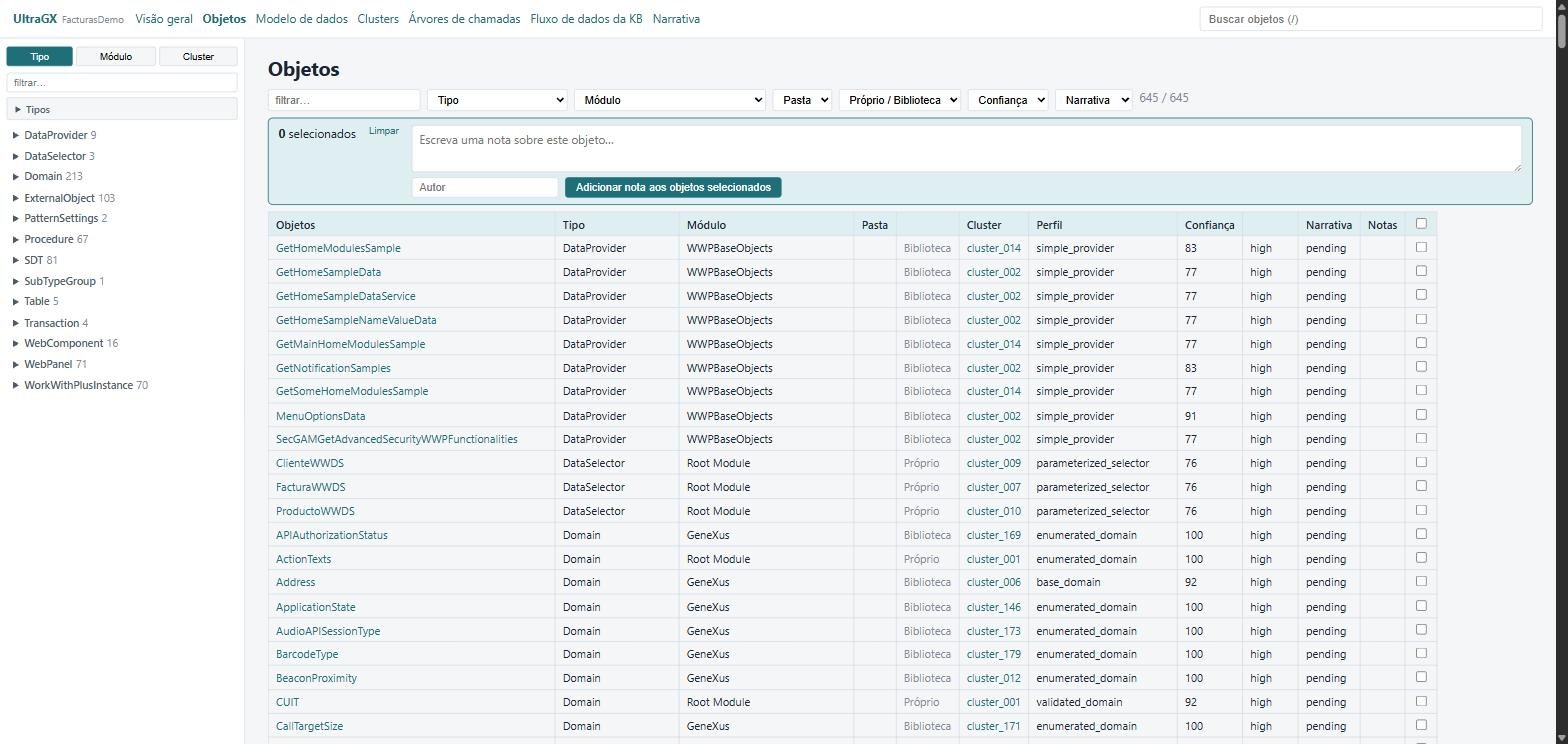
A lista de todos os objetos com filtros por texto, Tipo (incluindo a opção Objetos de negócio, que mantém Transações, Web Panels, Work Panels, Procedimentos, Relatórios, Query Objects e SDTs), Módulo, Pasta, Próprio / Biblioteca, Confiança e status da Narrativa. Acima da lista há uma caixa para adicionar uma nota aos objetos selecionados (veja Notas do usuário).
A barra lateral, presente em todas as páginas, agrupa os objetos por Tipo, Módulo, Localização (a mesma árvore de módulos e pastas do KB Explorer do GeneXus, quando a KB tem pastas) ou Cluster. Em Tipos se escolhe quais tipos mostrar e, se a KB tiver objetos de módulos importados, Ocultar objetos de biblioteca os deixa de fora.
Página de um objeto
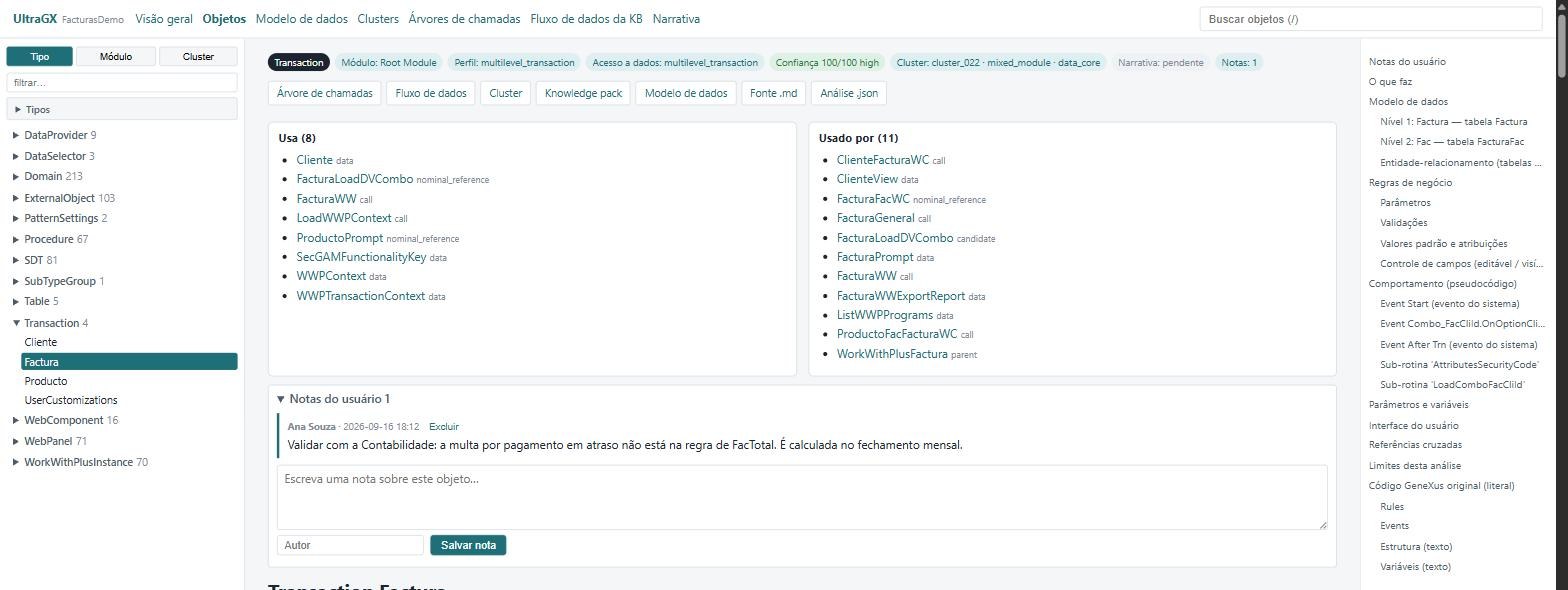
No topo estão a identidade do objeto (tipo, módulo, pasta, cluster, perfil funcional, acesso a dados, confiança), suas relações (Usa e Usado por, com links) e as Notas do usuário. Depois vem o documento, com o índice de seções à direita:
| Seção | O que contém |
|---|---|
| Resumo | tabela com os dados-chave do objeto |
| O que faz | descrição em prosa do seu propósito |
| Modelo de dados | (transações) níveis, atributos com seu papel (chave, chave estrangeira, fórmula, inferido) e diagrama entidade-relacionamento |
| Regras de negócio | cada regra, explicada uma a uma |
| Comportamento (pseudocódigo) | o que cada evento e sub-rotina faz, em pseudocódigo legível |
| SQL implícito (por For each) | a consulta que o GeneXus gera em cada For each: tabela base, joins, condições e ordem |
| Parâmetros e variáveis | a regra parm e as variáveis com seu tipo |
| Interface do usuário | campos, grids e sua tabela base, botões e ações, comportamento dinâmico |
| Significado de negócio | prosa da narrativa com IA, se foi gerada |
| Referências cruzadas | objetos relacionados |
| Limites desta análise | o que o motor não conseguiu determinar com certeza |
| Código GeneXus original (literal) | o código-fonte tal como está na KB |
No final, recolhível, está o Anexo determinístico do motor: a evidência técnica completa da análise (achados, riscos, pontuação, rastreabilidade). Serve para auditar uma conclusão; para ler o objeto não é necessário.
As seções mudam conforme o tipo: um Data Provider mostra sua saída, um SDT sua estrutura, um Domain seus valores etc.
Modelo de dados
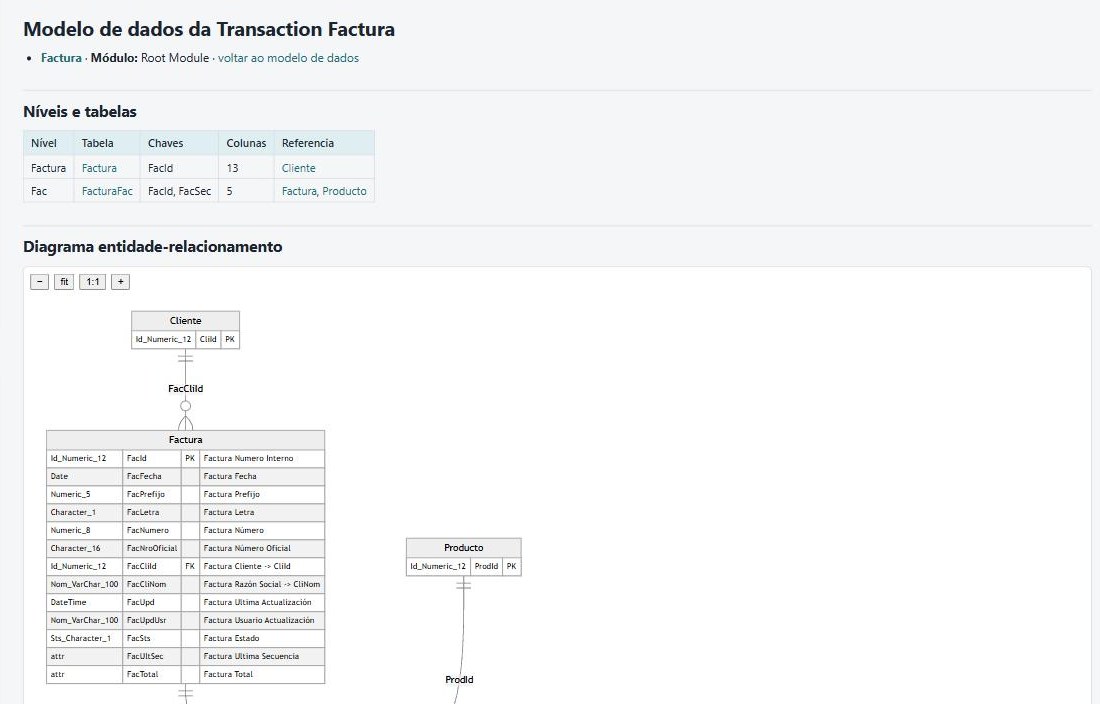
O diagrama entidade-relacionamento de toda a KB, a lista de tabelas e o detalhe por transação. Cada tabela tem sua página com colunas (chave primária e estrangeiras), relacionamentos, transações que a definem, objetos que a usam e um DDL conceitual.
Clusters
Um cluster é um grupo de objetos que trabalham juntos (por exemplo, tudo o que se relaciona com faturamento). O motor os monta a partir do grafo de dependências e da localização na KB. Cada cluster tem seu tipo, prioridade, objeto núcleo, pontos de entrada e membros, e três relatórios: Conhecimento (propósito, dados, riscos), Fluxo funcional (como o trabalho passa de um objeto a outro) e Plano de reconstrução.
O Roteiro de reconstrução (a partir da Visão geral) ordena os clusters em fases conforme suas dependências: primeiro o que não depende de nada, depois o que se apoia nisso.
Árvores de chamadas e fluxo de dados
- Árvores de chamadas: a partir de cada ponto de entrada, quem chama quem. Os nós do diagrama são clicáveis.
- Fluxo de dados da KB: quais objetos leem e gravam quais tabelas, para toda a KB, por cluster e por objeto.
Diagramas muito grandes não são desenhados automaticamente: aparece o botão Desenhar diagrama, e também é possível ver o texto com Fonte do diagrama.
Narrativa
Status da narrativa com IA por objeto: ok, degraded, error ou pendente. Veja Narrativa com IA.
A pasta de saída
Tudo o que o visualizador mostra está em arquivos dentro da pasta do projeto:
| Caminho | Conteúdo |
|---|---|
README.md | Ponto de entrada: como usar a pasta, mapa, glossário, clusters, tabelas e inventário completo. Sempre em inglês |
run_summary.json | Como foi gerada: fonte, entrada, idioma, quantidades, licença, aceitação |
kb_index.json | Uma linha por objeto: tipo, módulo, pasta, perfil, confiança, cluster e doc_path, o caminho exato do seu documento |
kb_graph.json | Grafo de dependências: relações de entrada e de saída de cada objeto |
kb_summary.md / .json | Métricas da KB |
kb_clusters.json, kb_clusters_summary.md | Clusters |
global_rebuild_roadmap.md / .json | Roteiro de reconstrução por fases |
acceptance_report.md / .json | Controle de qualidade final |
objects/ | Um <Tipo>.<Nome>.md e um .json por objeto, em pastas que replicam os módulos e as pastas da KB |
knowledge/ | Knowledge pack de cada objeto |
datamodel/ | Modelo de dados: índice, uma página por tabela e por transação, kb_datamodel.json |
clusters/ | Conhecimento, fluxo e plano de reconstrução de cada cluster |
calltree/, dfd/ | Árvores de chamadas e diagramas de fluxo de dados |
narrative/ | Resultado da narrativa com IA, um JSON por objeto |
annotations/ | Notas do usuário |
viewer/ | O visualizador. É regenerado: não o edite manualmente |
_pipeline/, _source_text/ | Uso interno: snapshots para detectar mudanças e, com a fonte live, o export de texto |
Os documentos são Markdown padrão com diagramas Mermaid: são bem lidos no GitHub, GitLab, VS Code ou Obsidian.